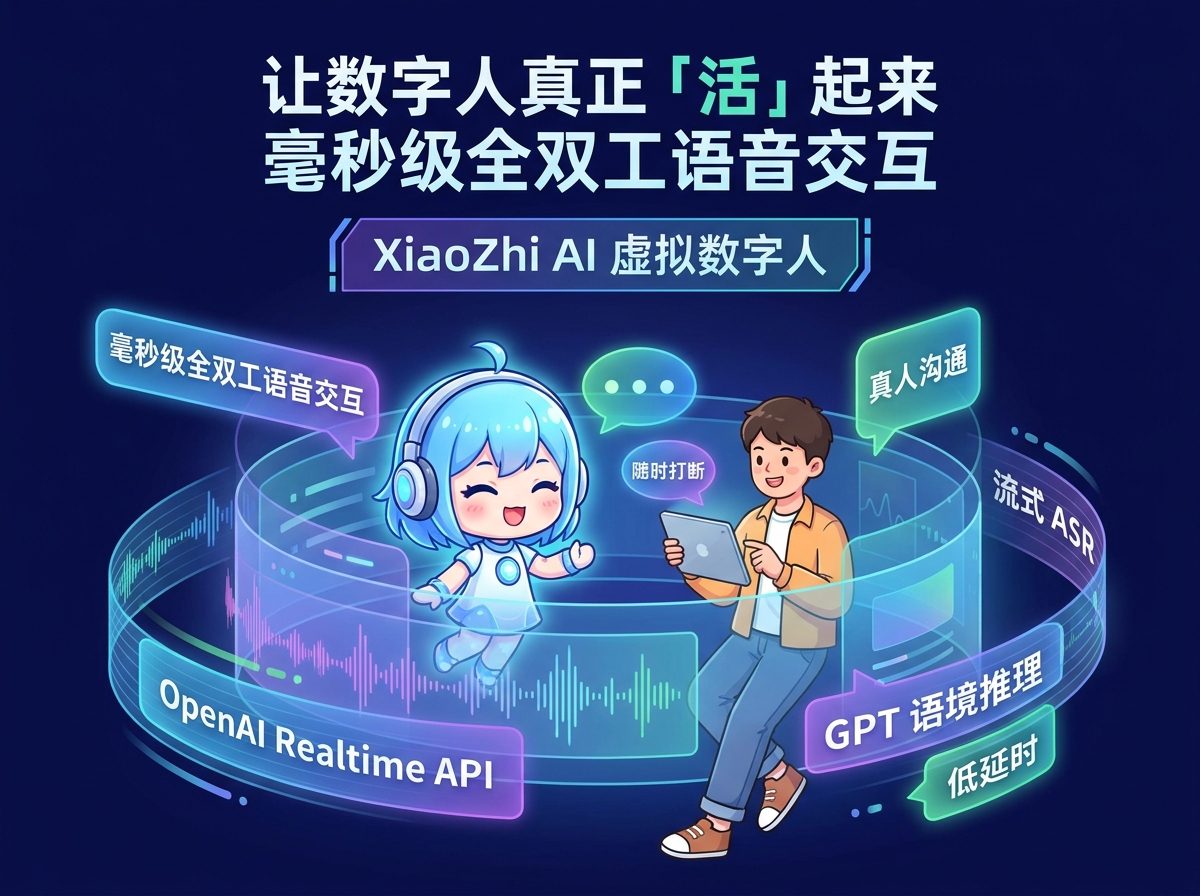
基于企业级WebRTC技术实现音频流的实时双向传输,彻底打破传统HTTP发送-等待的割裂感。您可以随时打断数字人的发言,沟通流畅度媲美真人面对面交流。集成OpenAI Realtime API,流式ASR语音识别、GPT上下文推理与TTS语音合成一体化处理,端到端响应延迟低至毫秒级。
内置精美的高精度Live2D虚拟模型(,支持细腻的动态表情变化、头部跟随、眨眼与微动作。语音输出时口型实时同步,让AI真正「活」起来。辅以实时音频波形可视化与粒子特效反馈,不仅是声音交流,更是全感官的视觉互动体验。
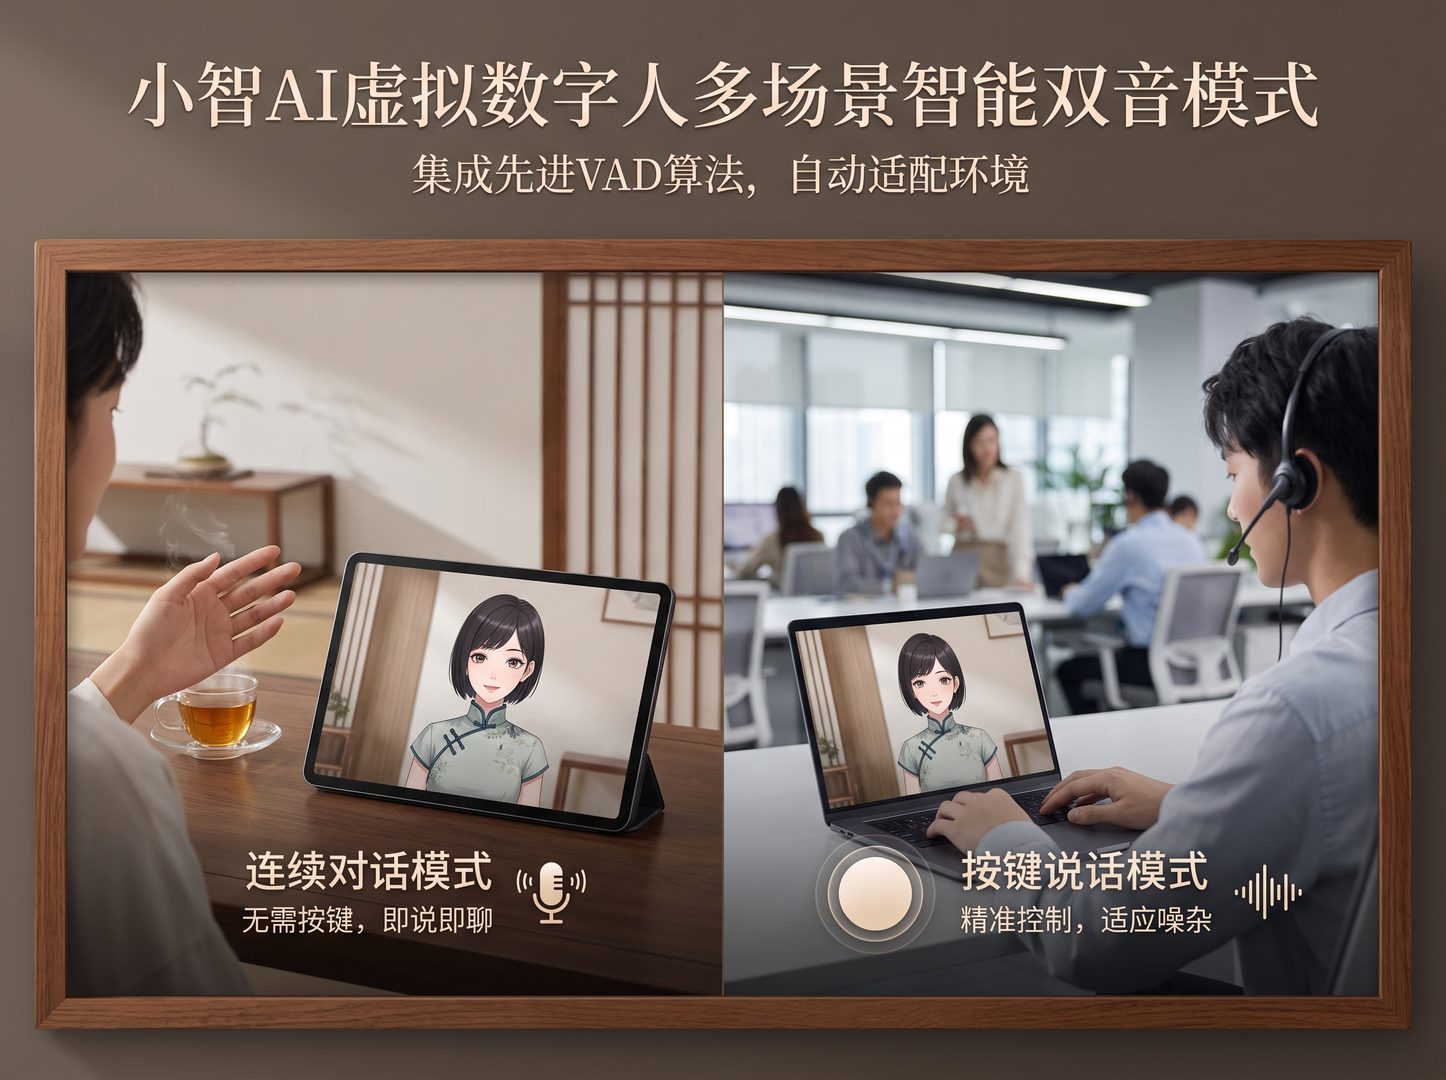
集成先进的VAD语音活动检测算法实现连续对话模式——开口即聊,无需按键。同时提供精准控制的按讲模式Push-to-Talk,适用于嘈杂环境或需要精确控制发言时机的场景。系统根据环境噪音自动适配最佳交互方式,无论安静居家还是嘈杂办公区都能流畅使用。
全双工实时通信带来的体验质变
| 对比维度 | WebRTC (本方案) | 传统HTTP轮询 |
|---|---|---|
| 通信模式 | 全双工实时双向 | 单向请求-响应 |
| 语音延迟 | 毫秒级 (<100ms) | 秒级 (1-3秒) |
| 打断支持 | 随时打断即时响应 | 需等待当前回复完成 |
| 连接维持 | 3s双向心跳保活 | 定时轮询高开销 |
| NAT穿透 | ICE/STUN/TURN | 无 |
" 自底向上六层架构:Docker容器化部署层 → WebRTC全双工实时通信层(3秒心跳保活+NAT穿透) → OpenAI Realtime API引擎层(流式ASR+LLM上下文推理+TTS语音合成) → VAD双模式语音管理层(连续对话/按讲智能切换) → Live2D虚拟形象渲染引擎层(动态表情+口型同步+粒子特效) → 多端输出层(PC/移动/大屏自适应)。无缝对接OpenAI Realtime API与WebRTC底层,赋予数字人顶级的上下文理解与极速流式语音能力。 "
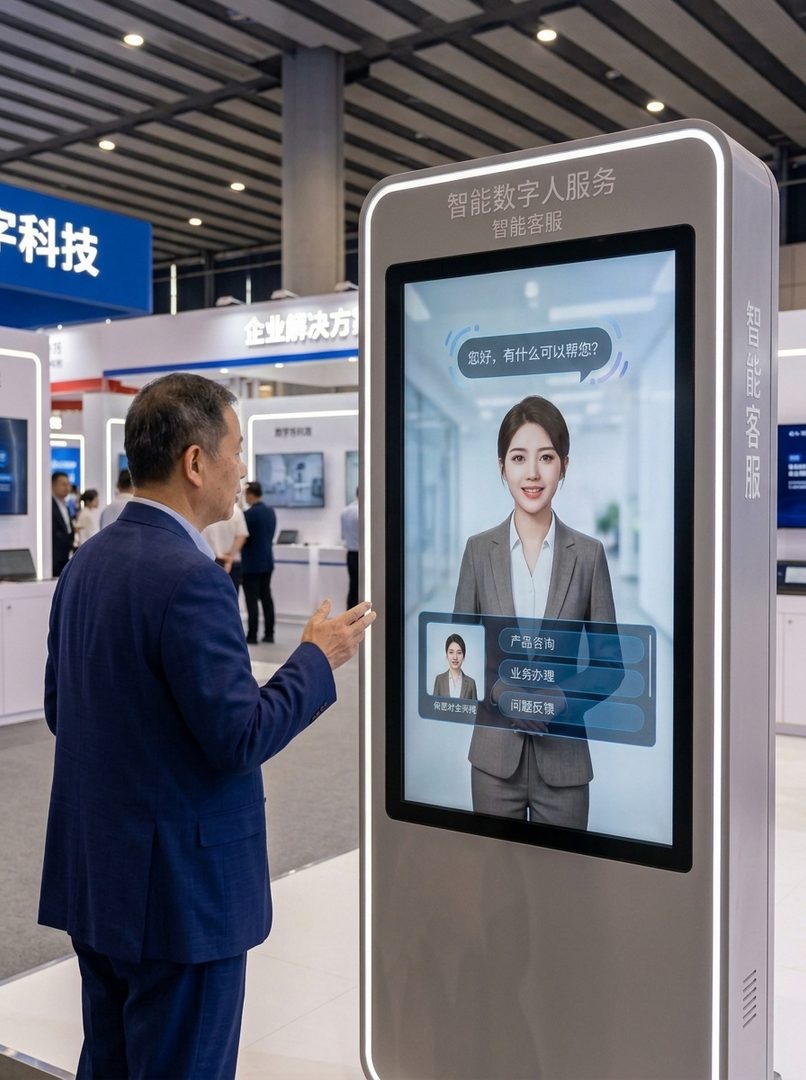
部署于企业官网、小程序或线下展厅大屏,7×24小时提供专业、有温度的客户咨询服务,显著提升品牌科技感与服务效率。
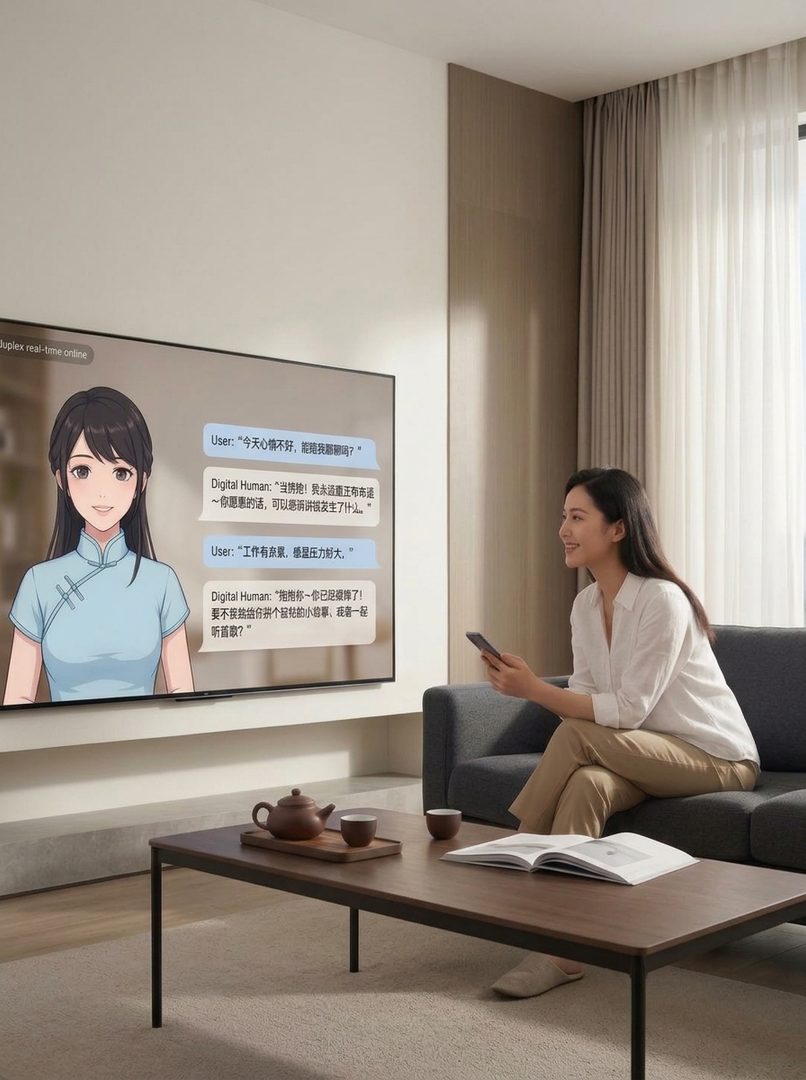
针对终端用户提供情绪价值、日常问答与事务处理,打造具备个性化记忆与互动的私人专属AI伴侣,让陪伴触手可及。
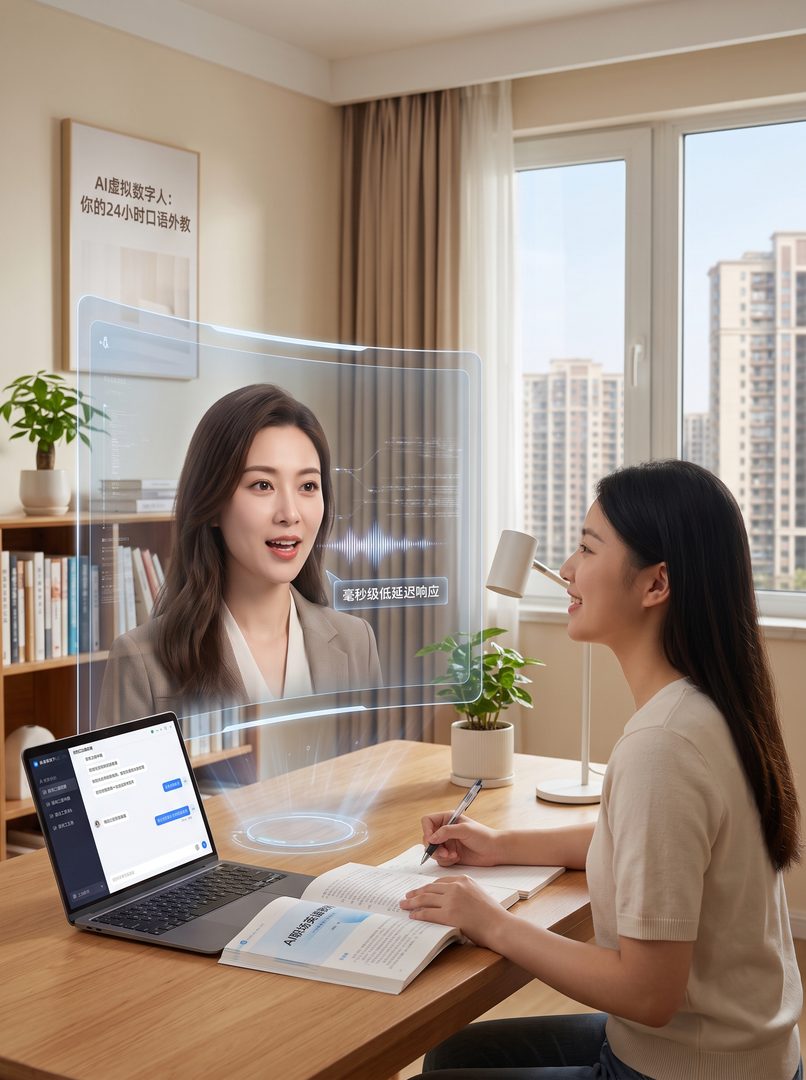
化身全天候虚拟外教或专业导师,提供极低延迟的语言对话练习、即时发音纠正与沉浸式互动教学体验。
强大底层技术支撑,保障业务全天候稳定运行
客户端与服务端每3秒检测,确保复杂NAT环境下WebRTC连接坚如磐石
自动检测空闲状态并优化资源占用,断连后支持智能语音唤醒恢复
全面支持uv包管理器、Docker容器化及Windows原生一键启动脚本
完美兼容PC端与移动端主流浏览器,HTTPS安全协议保障全平台一致体验
关于部署、网络要求与定制化的快速解答