从虚拟直播到在线教育,从短视频生产到展厅大屏,一个引擎覆盖全部数字人场景
7×24小时企业客服,对接知识库精准回答产品问题
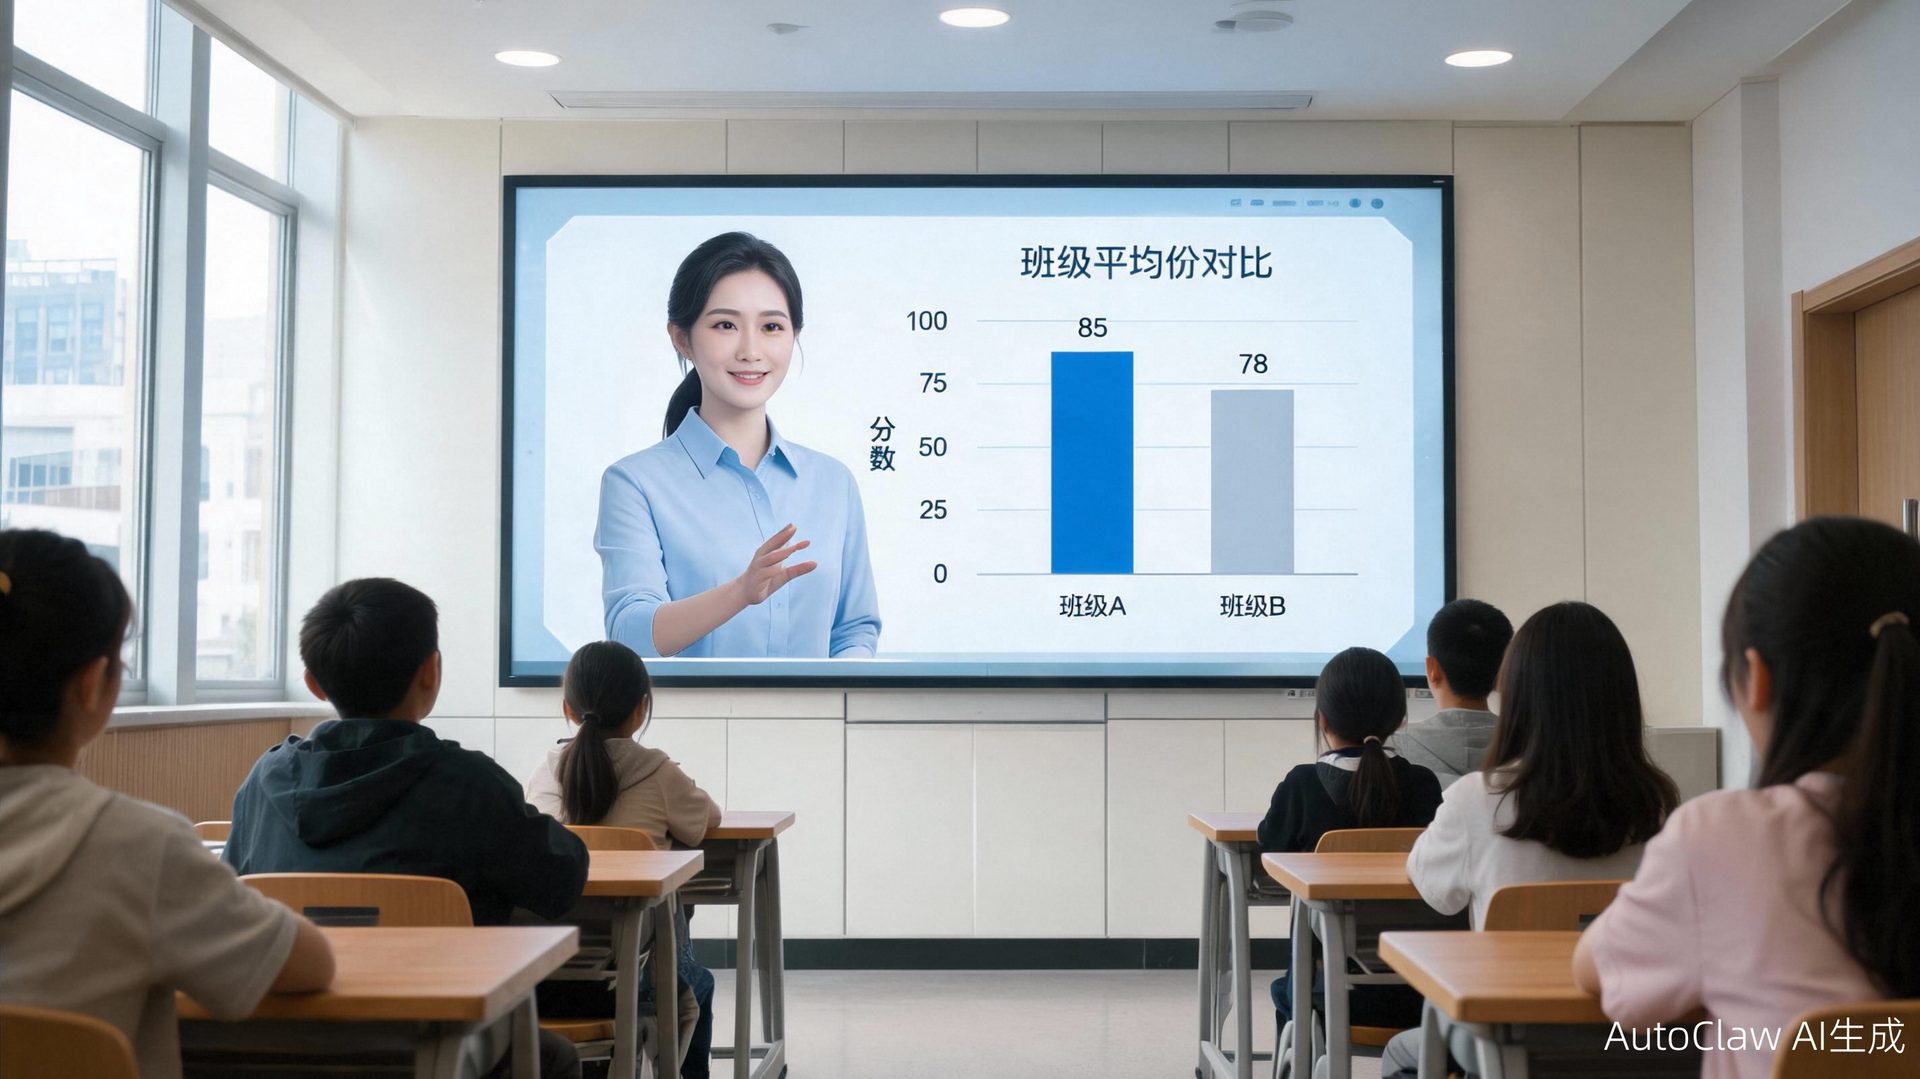
教师数字分身录制课程,一次拍摄无限复用
输入文案即可生成数字人出镜视频,极大降低内容成本
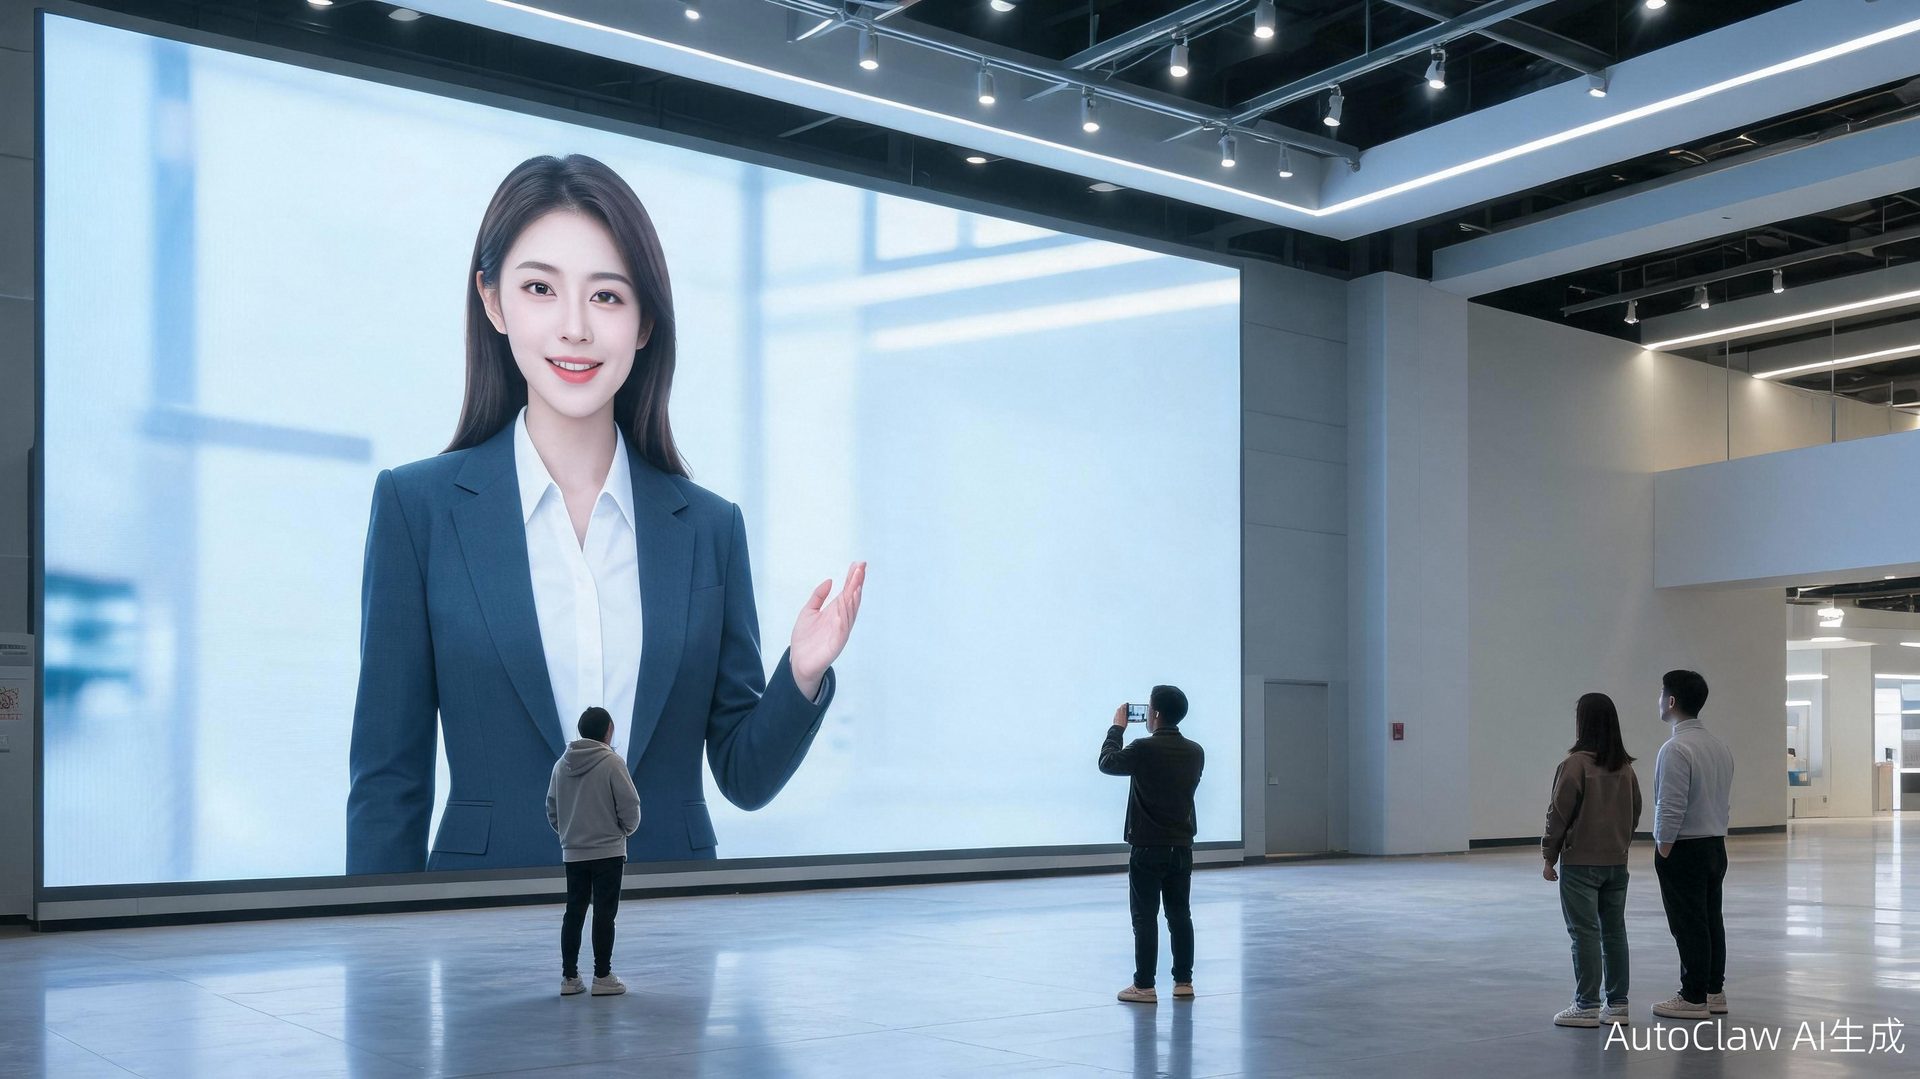
数字人讲解员在企业大屏互动讲解,支持语音输入
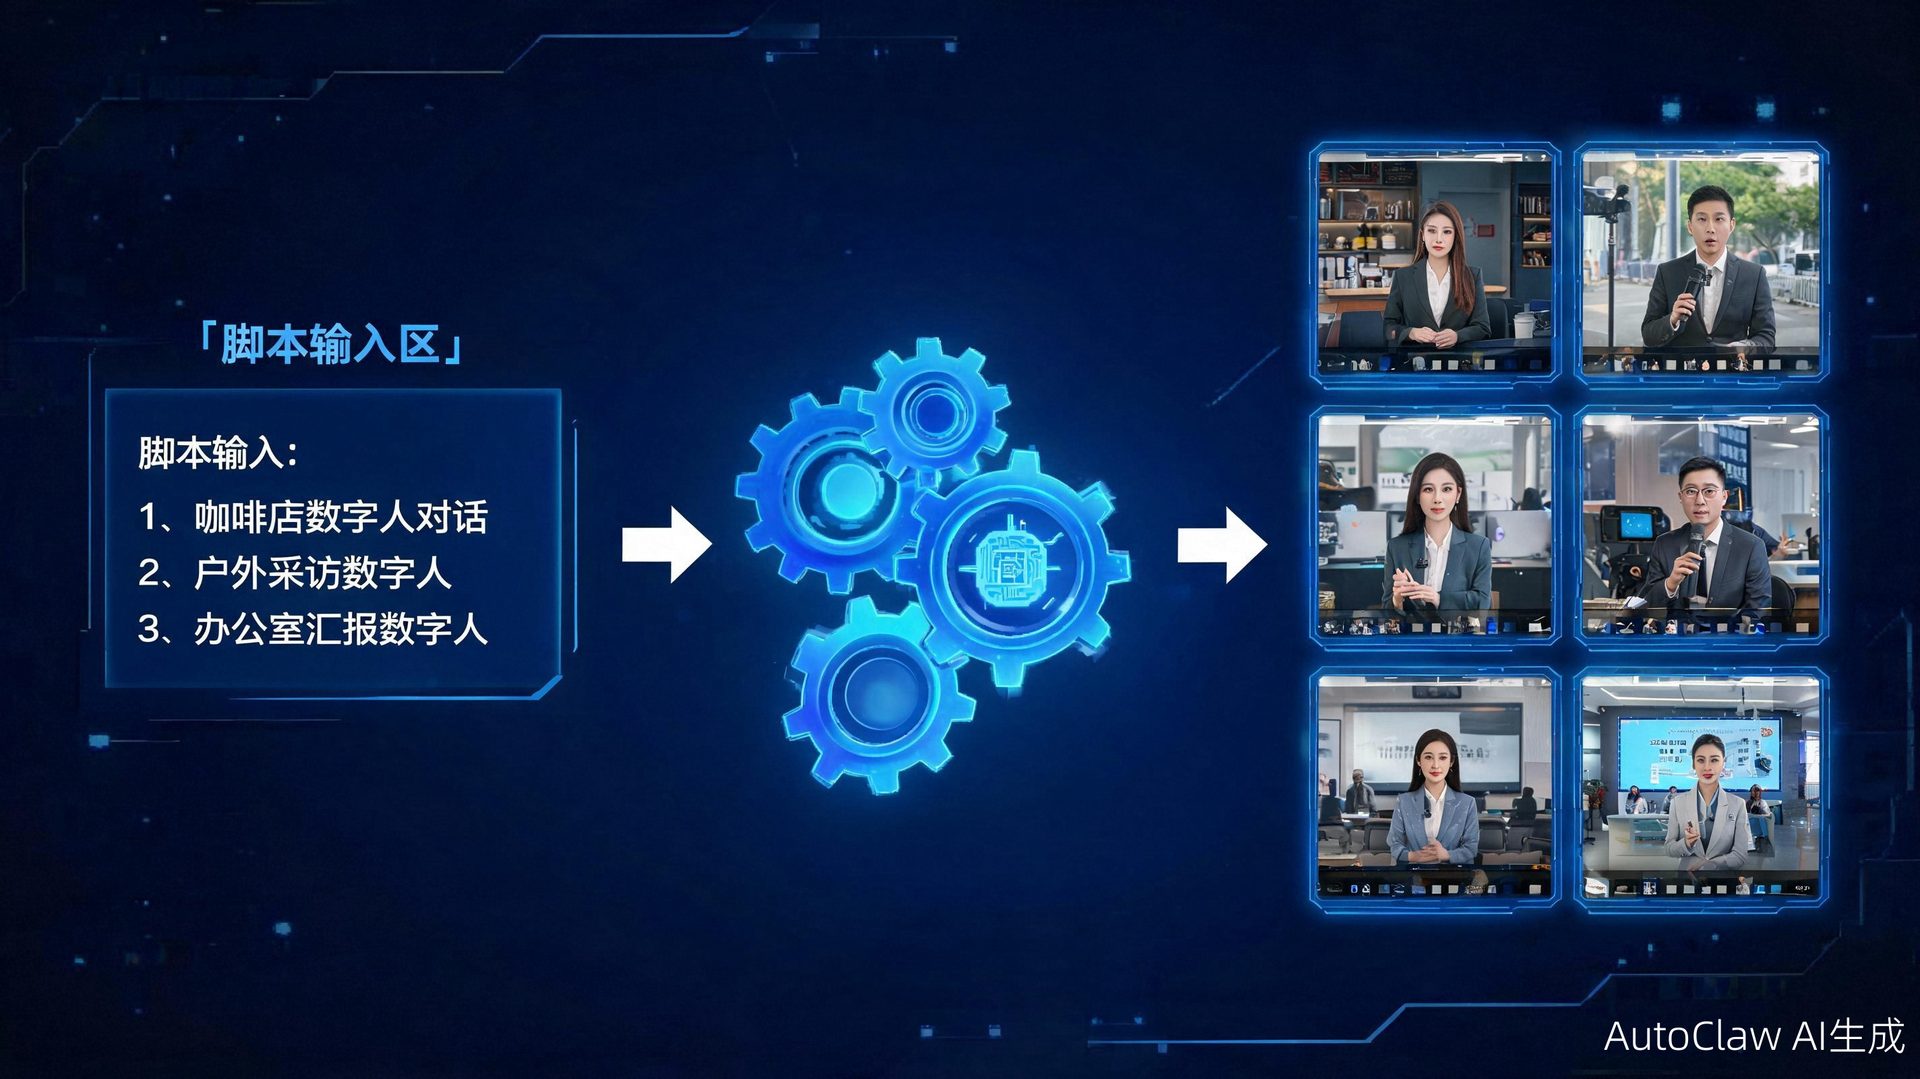
驱动企业级API批量生产数字人视频内容
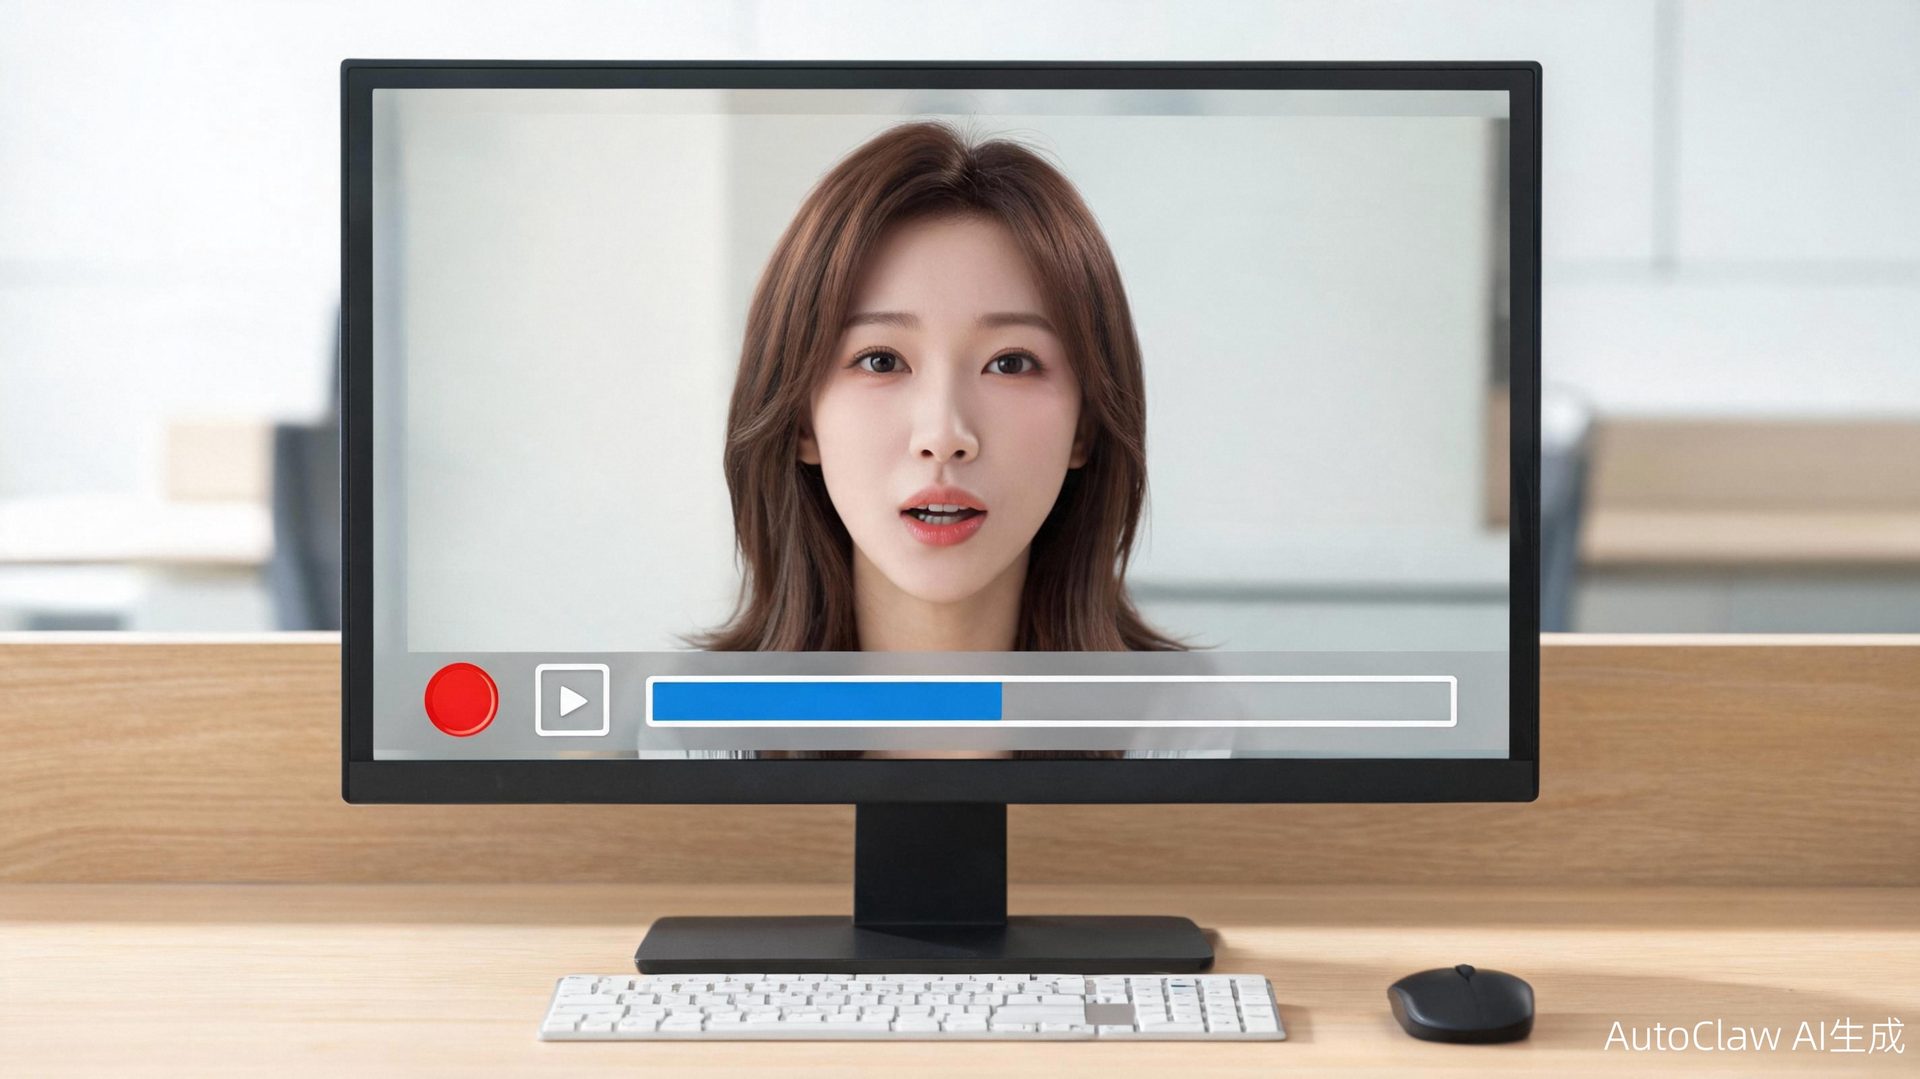
对话过程录制为MP4文件,方便存档或二次分发
macOS风格窗口展示数字人实时对话系统
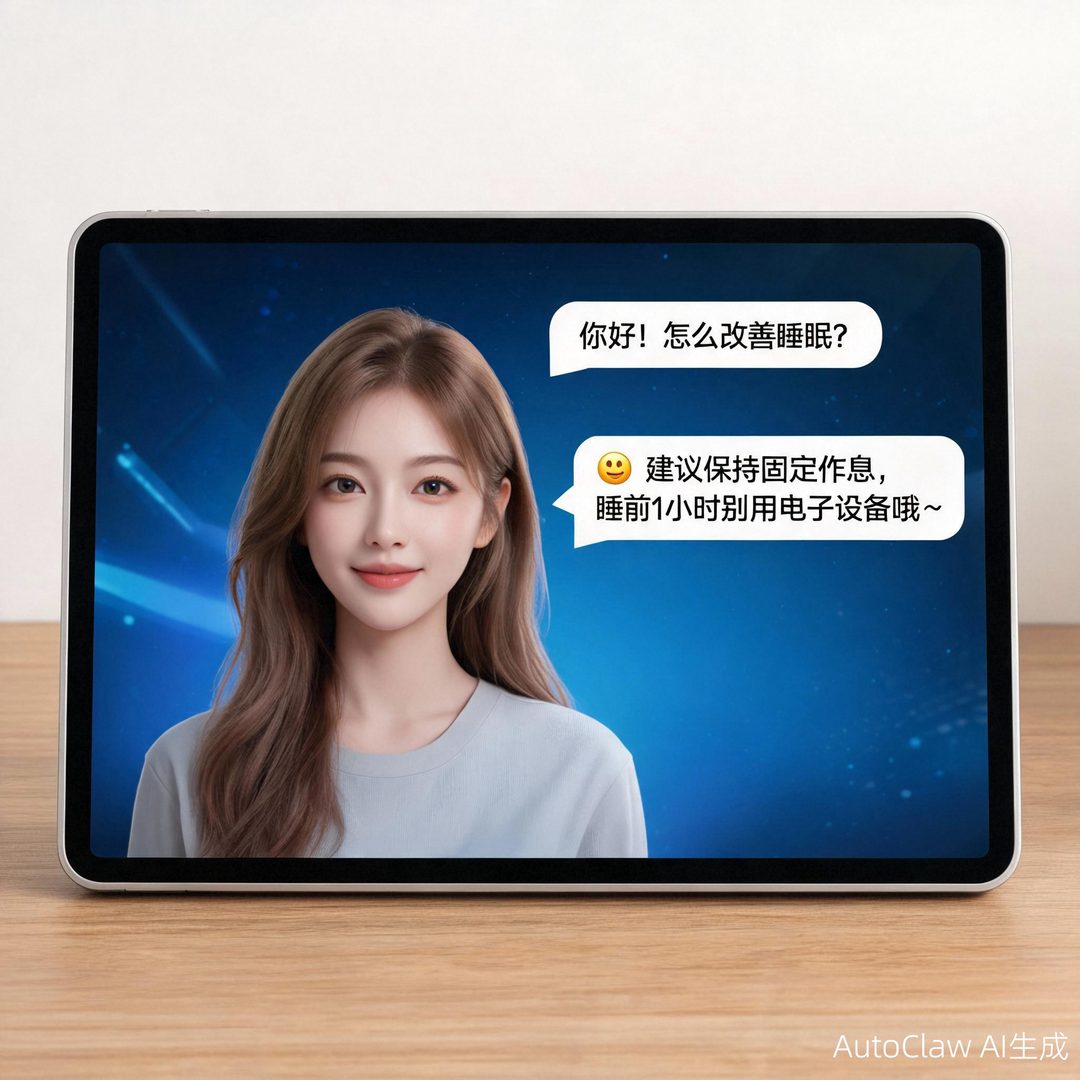
左侧为数字人实时渲染画面,口型与语音毫秒级同步;右侧为对话面板,支持文字输入与语音输入双模式,实时显示大模型流式回复。支持WebRTC浏览器端直接打开,即开即用。
文字或语音输入,数字人即时响应,流式大模型输出
Wav2Lip/MuseTalk推理引擎,口型精准匹配音频
说话过程中随时输入新内容,当前回答立即停止切换
输入文本或语音,数字人的口型、面部表情与音频毫秒级同步生成,对话体验自然流畅。底层支持Wav2Lip(轻量快速)与MuseTalk(高精度)双推理引擎,根据GPU算力灵活切换。全身视频模式下仅生成口部区域再无缝贴回原始画面,保持全身出镜的高清质感。
内置12+主流TTS引擎:CosyVoice一键声音克隆(几秒参考音频即可)、GPT-SoVITS少量训练定制、QwenTTS通义千问原生合成、Azure/腾讯云/豆包等云服务、EdgeTTS免费方案、XTTS/OmniTTS开源引擎。API调用时通过refaudio参数按会话动态切换音色,语速与情绪参数透传。
上传任意人物视频即可自动训练生成专属数字人模型。系统支持同时管理多个形象(avatar_id),每个会话可按需指定不同的数字人出镜。支持任意服装、背景、场景的真实视频素材,企业可为不同业务线打造独立的数字人形象矩阵,一个系统承载全部对外服务。
浏览器、直播平台、OBS推流软件 — 一套系统全部打通
浏览器直接打开即用,延迟最低,支持双向音频交互
推流到B站、抖音、YouTube等直播平台,24小时无人直播
接入OBS等直播软件作为虚拟摄像机源,灵活搭配
LiveTalking带来的生产模式变革
| 对比维度 | LiveTalking数字人 | 真人出镜拍摄 |
|---|---|---|
| 内容生产速度 | 输入文案秒级生成 | 拍摄+后期数小时 |
| 7×24小时可用 | 全天候在线,随时推流 | 需排期,受作息限制 |
| 多语言多形象 | 一键切换形象和声音 | 需重新录制 |
| 成本 | 一次建模,无限使用 | 每次出镜需人工+场地 |
| 24小时无人直播 | LLM自动生成话术推流 | 无法实现 |
| 打断交互 | 观众互动实时应答 | 直播弹幕易遗漏 |
内置12+国内外主流方案,覆盖克隆、云端、免费、开源全场景
几秒即可克隆
少量音频训练
通义千问原生
微软云端引擎
微软免费引擎
开源高质量
Coqui多语言
字节跳动引擎
企业级方案
阿里灵积
全场景覆盖
最新克隆方案
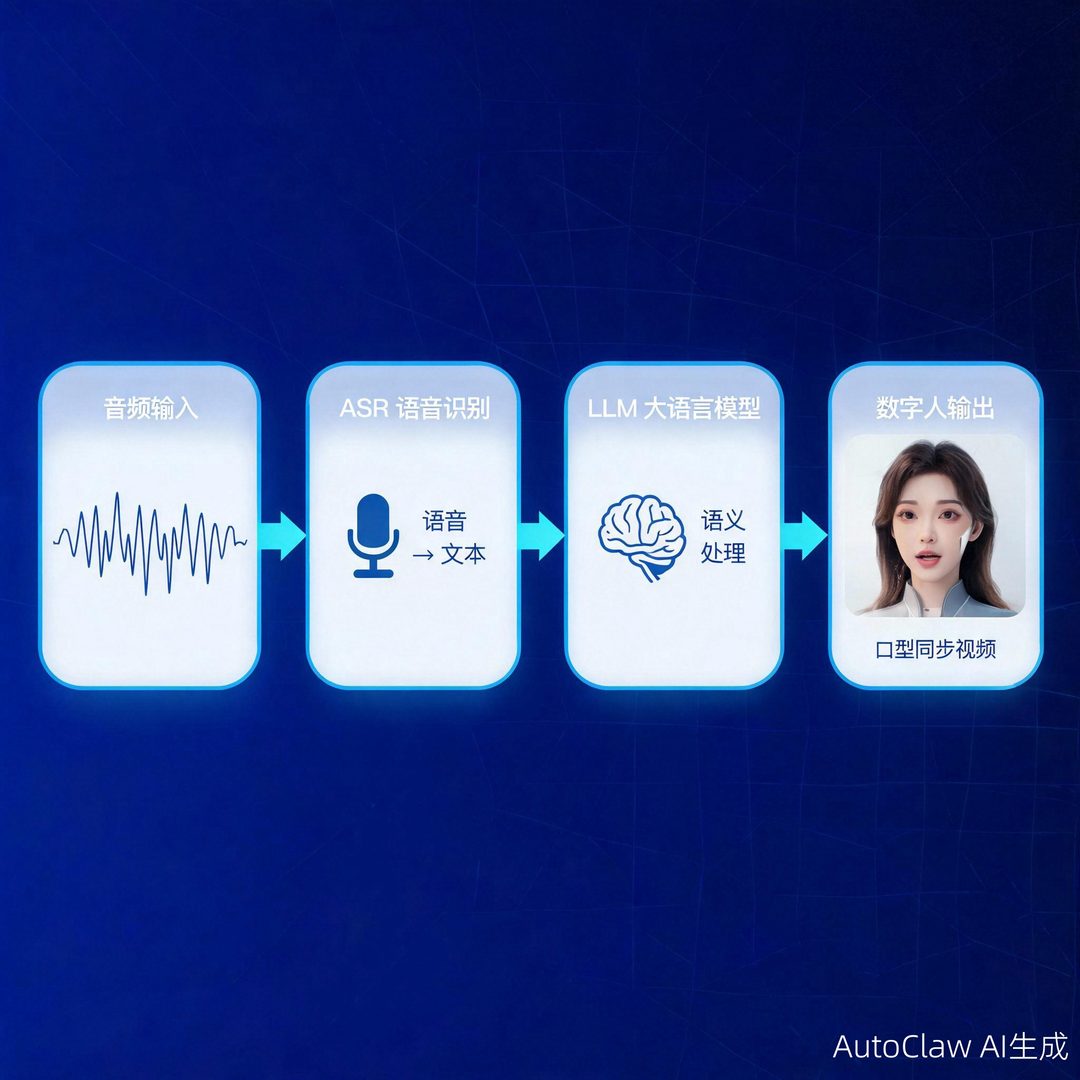
" 从用户输入到数字人输出全链路:用户上传视频 → 模型训练生成数字分身 → LLM大模型流式生成对话文本 → TTS引擎实时合成语音 → Wav2Lip/MuseTalk口型驱动推理 → 全身视频无缝拼接合成 → WebRTC/RTMP/虚拟摄像头三路分发输出。支持GPU服务器部署(最低RTX 3060 8GB),Docker容器化一键启动,Apache 2.0开源协议商业友好。 "
从形象训练到多平台部署,一站式交付